
主题
上传数据做分析:从数据画像到报告里的 [D n]
数据页上最常见的两个疑问是「为什么它跑了这几个作业而不是我想要的那个」和「这个指标为什么灰掉了、报告里没有它」。这一页把数据分析阶段按代码讲一遍:文件进来后经过了什么、每个数字是怎么来的、你能在哪一步干预。
能传什么
- 上传白名单是 pdf / docx / csv / xlsx / xls / txt / md,单个文件 ≤ 50 MB,一次最多 10 个。只有 CSV 和 Excel(.xlsx / .xls)会触发数据分析阶段,PDF、Word 是材料,进的是解析和写作,不进沙箱。
- Excel 只读第一个工作表;进沙箱前统一转成 CSV,脚本里只认一份
data.csv。 - 研究类型选「数据分析」「综合研究」时数据分析阶段固定存在;「论文初稿」只有上传了数据才展开这一阶段。没上传数据集的任务,阶段会直接标「未上传数据集,跳过」。
- 传了多份表格,阶段会给每一份画像并各自规划作业;但追加分析和沙箱实验只用第一份(按上传顺序)。
脱敏卡:自动脱敏还是保留原样
上传时会读前 200 行做个人信息判断:身份证(过校验位)、手机号、邮箱、银行卡、ICD 编码按值扫,姓名 / 诊断 / 联系方式类按列名判。命中率 ≥ 30% 的列才提示。确认页会出一张「xxx 里可能有个人信息」的卡,两个按钮:
- 自动脱敏(默认,不点也是它):分析读取数据时把整列换成盐化哈希
h_+ 12 位。同一任务内同值同哈希,分组统计、计数照常能做,但原始值不进沙箱、不进任何事件。文件本身不改写,你下载回去的还是原件。 - 保留原样:原值进沙箱。这是需要留痕的例外,执行记录里会多一条「你保留了个人信息」。
只能在确认前决定,开始研究后不能改。界面上的样例只是打星显示,不是脱敏后的值。
数据画像
阶段第一个作业是画像(数据页列表里标「画像」,不占作业编号):行数、列数,前 80 列每列的类型、缺失率、唯一值数,数值列再给最小 / 最大 / 均值 / 标准差 / 中位数和 8 桶直方图。数据页顶部那张表就是它,表格只显示前 40 列。
行数超过档位上限会先抽样再分析:免费版 200,000 行、专业版 2,000,000 行、企业版 10,000,000 行。有分类列就按第一个分类列分层抽,否则随机;固定种子 42,同一份数据重跑得到同一份样本。抽样后数据页显示「基于 N 行抽样」,看板会记一条降级说明,报告里的数字必须标注基于抽样。画像自己的指标不可引用、不占 D 编号。
作业是怎么规划出来的
规划模型拿研究问题和画像摘要(不是原始数据),出 2–5 个作业,只有六种:描述统计与分布、相关性分析、分组比较、回归分析、时间序列趋势、自定义。几条硬规则:
- 回归 / 分组比较 / 相关的因变量必须是画像里真实存在的数值列;模型编的列名会被丢掉,改按研究问题在列名里猜一个(猜不到就用第一个数值列)。
- 年份 / 日期列不当因变量,也不当连续型自变量;标识列(id / 序号)一律不进分析。
- 回归的自变量按画像清洗类型,文本列做哑变量;作业标题由代码按实际模型生成(「体重 ~ 物种 + 性别 + 鳍长(OLS 回归)」),不是模型起的自由标题。
- 没有模型或模型失败时退回规则模板:描述统计恒有,≥ 2 个数值列加相关,有分类列加分组比较,≥ 3 个数值列(或 2 个 + 分类列)加回归,列名含 date / time 加时序。这种情况看板会记「AI 模型未配置,这一步改用了规则方法」。
规划完成、第一个作业跑之前,这份分析计划会被冻结(作业清单 + 检验族),之后实际跑的作业与计划有出入会作为「偏离」如实写进报告的方法节,不会禁止也不会隐瞒。
免费档目前按专业档口径规划,阶段里通常规划 5 个左右的作业;每个任务能追加多少作业以你的额度为准(用量页「本次使用」一行可见),到上限时数据页的追加入口会禁用。
沙箱里跑了什么
每个作业是一段完整的 Python 脚本:固定骨架 + 主体。五类模板作业的主体是写死的统计代码,不经模型:描述统计 + bootstrap 置信区间、相关 + max-statistic 置换检验、ANOVA / Welch + η² 置换、OLS(分类变量哑变量)+ R² 置换、线性趋势 + 斜率置换。只有「自定义」作业的主体由代码模型按你的描述写。数据页每个作业都能「查看脚本」,带 sha 指纹,依赖版本固定(pandas 2.2.3、statsmodels 0.14.4、scikit-learn 1.5.2 等)。
脚本提交到独立的沙箱执行器,作业容器没有网络、非 root、只读文件系统。资源按档位:免费版 1 核 / 1.5 GB / 600 秒,专业版 2 核 / 3 GB / 1800 秒,企业版 4 核 / 6 GB / 3600 秒。置换和 bootstrap 次数为 1000 次(免费档目前同专业档)。
脚本报错时,模型拿报错尾部和脚本做最小修改再提交,最多修 3 轮(共 4 次尝试),数据页作业行显示「第 N 次」。沙箱不可达(维护、重启)时作业保持排队,看板显示「分析服务维护中」,每分钟自动重试提交,不算失败。
验证器、D 编号与零模型
作业结束后跑三道验证器:文件存在(必须产出 metrics.json)、数值合理(无 NaN / Inf,相关系数在 [-1, 1],p 值在 [0, 1],抽样后样本量 ≥ 5)、与计划一致(模板作业的固定指标键必须全在;自定义作业宽松判)。回归还多一道:脚本报告的实际模型公式必须与规划的因变量 + 自变量集合完全相等,多一个协变量或少一个都不通过。
任一道不过,这个作业的所有指标都标为不可引用:数据页灰显并提示「验证器未通过,报告不可引用」,写作门禁会拒绝正文引用它们。指标仍然入库,你能看到值,只是不进报告。
通过的指标每个拿一个 D 编号,任务内连续、跨作业唯一。写作时模型只写占位符,代码展开成数值并附 [D n] 记号;正文里出现不来自指标表的裸数字会被标为待核实。报告里点 [D n] 会跳回数据页并高亮那一行。
「vs 随机基线」那一栏是零模型:置换检验或 bootstrap 的结果,显示观测值优于多少比例的随机基线、置信区间和 p 值。
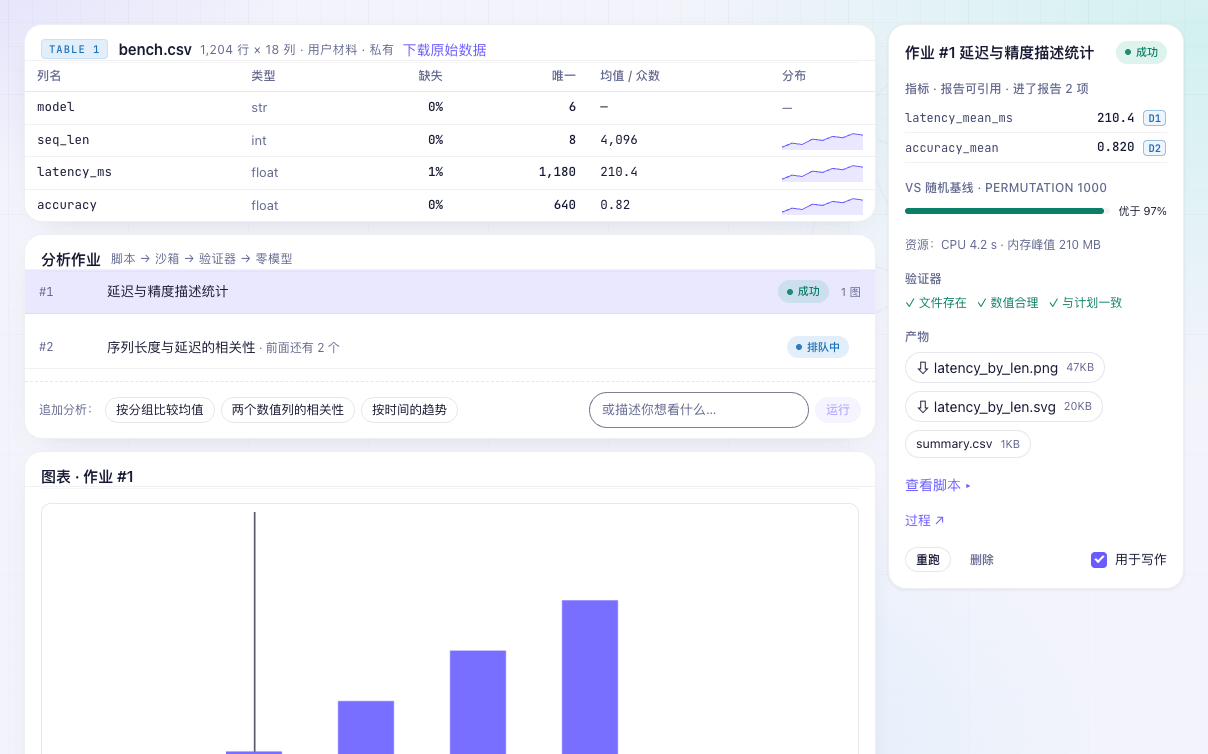
左侧从画像表看到每个作业和它的图,右栏点开某个作业:指标旁的 [D n] 就是报告里能引用的编号,验证器三项全绿才可引用。
作业跑完后还有两步你在指标表里会看到:
- 多重比较校正:同一因变量 + 同一作业类型算一族,族内的检验 p 值按 Holm 校正,写成
p_value__adj(注明「holm 校正,族内 k=N」);原始 p 保留,两者都可引用。只有 1 个检验的族也登记,报告写「未校正」。 - 稳健性重跑:每个回归 / 相关 / 分组比较作业追加一个稳健性作业,变体预先写定(秩相关、剔除 |z| > 3、HC3 标准误、剔除高影响点、bootstrap 区间),判据也预先写定:效应方向变了或 α = 0.05 下显著性变了算「翻转」。整个阶段稳健性预算 300 秒,没跑到的报告写「未做」。这些作业不占免费档的作业名额。
图表
模板作业出图:分布直方图、类别计数、相关矩阵、散点、分组箱线、回归拟合、时序曲线,每张同时存 PNG 和 SVG,数据页「图表」卡按作业展示,点开放大可分别下载。坐标轴用列名的人话对照表,不印原始列名。
写作默认按作业顺序取前 4 张图;右栏「用于写作」开关可以把某个作业整个排除出报告。
作业失败或结果不对,怎么办
- 重跑:同一脚本再提交一次,清空上次指标重新编号;在跑的作业不能重跑。
- 删除:报告里引用了它指标的句子会被标为待核实,所以删除前有二次确认。
- 追加分析:数据页底部三个 chip(按分组比较均值 / 两个数值列的相关性 / 按时间的趋势)或自由描述「或描述你想看什么…」,自由描述走自定义作业,模型按你的话写脚本;追加的作业不重跑整个阶段。
- 所有作业都失败时看板会记「所有数据分析作业都失败了」,报告只做数据描述;从进度页「从这一步重试」数据分析阶段会清掉本阶段的作业重新规划。
- 回归的「模型变量与规划不一致」会单独记一条降级,那次回归的系数不进论文。