
主题
实验设计与沙箱实验:假设怎么排、方案怎么出、哪些真的跑了
设计页上最容易被误读的是「这些方案是不是已经做过了」。答案分两层:方案(REP)是给人执行的计划,耗时是估算;但排名前 2 的方案会被落成预注册协议,在沙箱里对表格数据真跑一遍,结果、判定和报告清单挂在方案卡下面。这一页按代码说清两层各自的边界。
哪些研究有这个阶段
研究类型「实验设计」(文献 → 实验设计 → 导出)和「综合研究」(文献 + 数据分析 → 实验设计 → 写作)。文献综述、数据分析、论文初稿三种类型没有这一阶段。没有配置模型时整阶段跳过——启发式假设没有价值,不做规则版。
假设从哪来、怎么排
模型拿研究问题、文献脉络(最多 20 条)、数据画像和已有的数据发现,一次给 4 条可证伪的假设。每条假设必须点名分析计划里规划的因变量:不点名的丢弃,按缺口补生成一次,仍不点名的丢弃并在看板记一条降级。没有一条合格时阶段以「跳过」结束。
每条假设附三样东西:
- 最近工作:在本任务筛入的文献里按关键词重叠取前 3 篇,模型给一句差异。没有重叠文献时显示「新颖性未对比(缺最近 3 篇已有工作)」;差异没生成时只列标题。
- 可行性:算力需求 / 复现记录 / 数据可得三项各 1–5 分,页面显示三项均值取整的五点;失败显示「可行性未评估」,请自己判断。
- 胜场:4 条假设两两比较共 6 场,模型每场判一个胜者并给理由,按胜场排名,第 1 名自动采纳为主方案。「查看比较记录」能看每场理由;你可以把任何一条改为采纳,只允许一条。
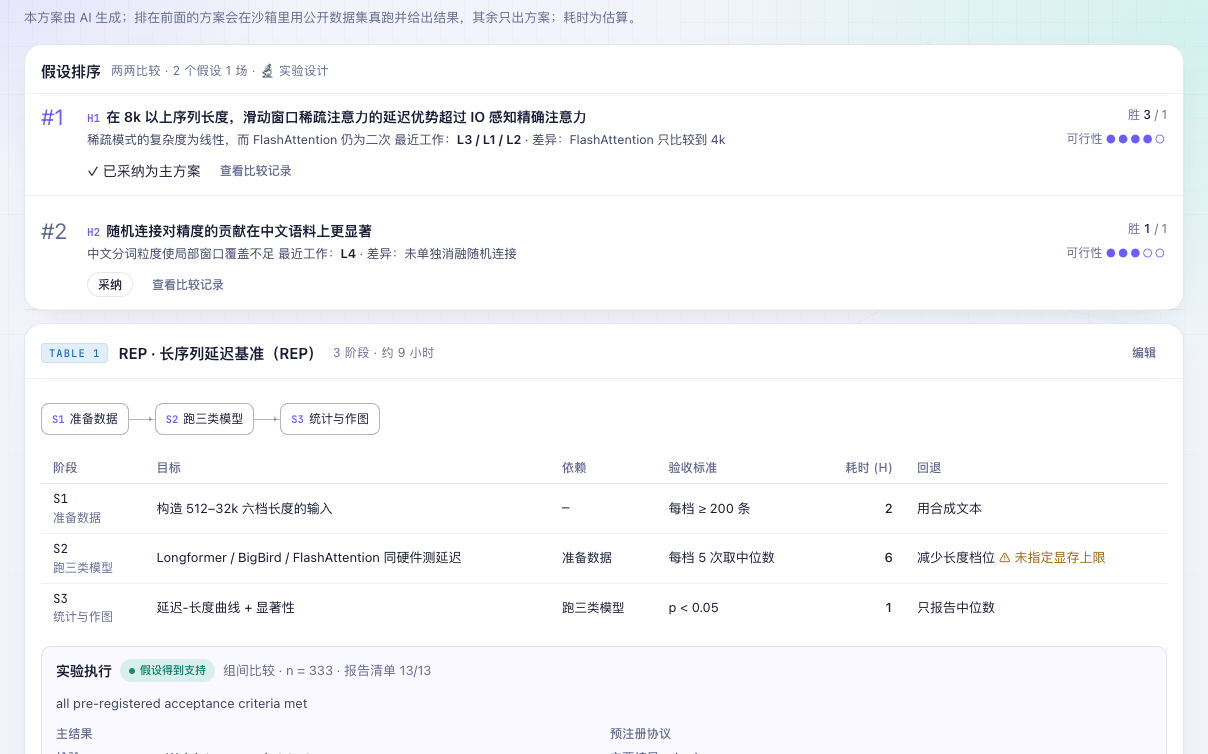
假设按胜场排在最上面,采纳的那条标「主方案」;下面的 REP 表缺字段的行会标黄提示;最底下的「实验执行」块才是沙箱真跑出来的结果。
REP 方案:给人执行的计划
排名前 3 的假设各出一份 REP:阶段表每行五个字段——目标、依赖、验收标准、耗时(小时)、回退,缺任一项该行标黄并提示「缺字段」;另有参数配置、风险与可行性证据、流程图。总时长是各阶段耗时之和,是估算,不是系统执行时间。
目标、验收、耗时三列可以行内编辑后保存,依赖与回退由系统维护。你手改过的方案和采纳过的假设标「已手改」,重跑实验设计阶段时保留。每份方案可导出 REP JSON 和流程图 SVG;「实验设计」类型任务没有写作阶段,最终交付的是设计包 zip(假设、方案、流程图、可行性表)。
哪些方案会真跑,跑在什么数据上
排名前 2 的方案会进入执行。执行的前提是有一张表格:
- 你上传了 CSV / Excel:用第一份,脱敏规则与数据分析阶段相同,进沙箱的那份字节会记 sha256 指纹。
- 没上传:系统按假设生成 3 个英文检索词去 UCI 机器学习库找公开数据集,只要行数 ≥ 30、不超过档位行数上限、文件 ≤ 50 MB、能解析的候选;模型从候选清单里按编号选一份并给理由,选不出就如实说没有。选中的数据集登记为任务输入,来源 / DOI / CC BY 4.0 许可 / 引用论文一并记录,执行记录里有「使用公开数据集:xxx(UCI #n)」。
- 两者都没有:看板记「没有可用于实验的数据……本次只产出实验方案,不执行」,方案照常交付。
所有真跑的实验都是对表格数据的计算实验:组间比较、回归、相关、预测模型、时间趋势五类之一。REP 里写的湿实验、训练大模型、采集新数据这类阶段不会被执行,那是给人的计划。设计页顶部那句「只设计不执行」是执行功能上线前的旧文案,以方案卡里的「实验执行」块为准。
预注册协议:模型写协议,代码校验并冻结
模型只做一件事:把假设和方案翻译成一份协议——设计类型、主要结局、分组 / 暴露 / 时间列、协变量(≤ 5)、检验、单双侧、α、最小有意义效应、验收标准。**统计代码模型一行不写。**代码逐项校验:
- 列必须真实存在且类型对(结局列须为数值列,分组列须为 2–20 个水平的类别列),不对就整份协议判不可执行,方案卡显示「未执行」并给原因。
- α 只接受 (0, 0.1],否则回 0.05;侧别不合法回双侧;最小有意义效应缺省两组 Cohen's d 0.5、多组 Cohen's f 0.25、回归 f² 0.02、相关 r 0.1。
- 两组用 Welch t / Mann-Whitney,多组用 ANOVA / Kruskal,不匹配的替换并记进协议的 validationNotes。
- 验收条目只能引用固定指标(primary_p / effect_size / 置信区间 / perm_p 等),且必须有一条显著性条目,没有就自动加
primary_p < α。
校验通过的协议连同数据指纹、来源和冻结时间一起落库并发事件,之后作业才开始跑。报告清单里「预注册」一项就看冻结时间是否早于沙箱作业开始时间。偏离会如实记录:脚本在沙箱里报错被模型修过、沙箱拿到的是抽样数据、数据指纹与登记不符。
五类统计模板算了什么
脚本 = 协议字面量 + 公共函数 + 该设计类型的固定模板,跑在与数据分析相同的沙箱里(无网络,资源按档位)。每类模板必写样本量、排除行数、α、主估计与 95% 区间、主 p、效应量,以及至少一个稳健性变体:
- 组间比较:Welch t / Mann-Whitney / ANOVA / Kruskal,效应量 d 或 f,置换 p,功效与所需样本量,Shapiro / Levene 假设检验;变体:秩检验、20% 截尾、bootstrap 区间。
- 回归:OLS 配 HC3 稳健标准误,报主暴露的系数,f² 功效,Breusch-Pagan / Durbin-Watson / 残差 Shapiro / 最大 VIF 四项假设检验;变体:剔除 Cook 距离高影响点后重拟合、Huber 稳健回归、bootstrap 区间。
- 相关:Pearson + 置换 p + 功效;变体:Spearman、剔除极端值、bootstrap。
- 预测模型:随机森林 vs 哑基线,5 折 × 3 次重复交叉验证,Nadeau-Bengio 校正 t 检验,置换检验;变体:换种子重跑、线性模型。
- 时间趋势:线性斜率 + 置换 p;变体:Kendall τ、Theil-Sen 斜率;时间点太少直接判「结论不确定」。
多重比较、判定与报告清单
同一任务里 ≥ 2 个实验都成功时,主 p 按 Holm 校正,页面显示「校正后」;单个实验用原始 p。
判定由代码按冻结的验收标准给,三种:
- 假设得到支持:验收条目全部满足;但如果超过一半的稳健性变体失去显著性,改判「结论不确定」。
- 假设未得到支持:验收不满足,且功效 ≥ 0.8(能检出最小有意义效应)。预测模型看相对基线增益的区间下界 ≤ 0。
- 结论不确定:验收不满足但功效不足——没检出不等于不存在。
判定理由原文显示在结果块里。下方「Nature 报告清单」是 15 项机器可核对的条目(样本量、排除、种子、检验描述、精确 P、效应量与区间、多重比较、假设检验、零模型、稳健性、预注册、数据与代码可得性等),每项 met / unmet / na 都由指标表和产物决定,附证据原文,不采信模型自述。
已知限制
- 一份研究只跑 2 个实验、只用 1 份数据;实验作业占沙箱时限(免费版 600 秒),大表会被抽样并记为偏离。
- 结果数值全部来自指标表(带 D 编号),写作可引用;实验执行失败不拖垮设计阶段,方案照常交付,可从实验设计阶段重跑。
- 公开数据集只接 UCI 一个源。