
主题
文献是怎么找来、怎么筛掉的:从检索式到 A/B/C 等级
文献页上最常见的疑问是「为什么这篇进了、那篇没进」和「我要 50 篇,怎么只给了 43 篇」。这一页把文献阶段的每一步按代码讲一遍,看完你能自己核对文献页和执行记录里的每个数字。
检索式从哪来
主题解析阶段会把你的课题改写成一段研究问题、3–7 个子问题、3–6 个英文关键词和对应中文关键词。文献阶段开始时,模型(抽取用途)拿着这些东西生成检索式,每条检索式挂到一个子问题上,要求覆盖不同角度(方法 / 对象 / 应用 / 评测)。
几条硬规则:
- 英文课题至少带 1 条中文检索式,中文课题至少带 1 条英文检索式。
- 检索式不带年份,年份窗口单独控制,默认近 10 年,确认页可改起止年。
- 最多 12 条检索式,每条最多发给 6 个源;中文检索式只发给 OpenAlex、Semantic Scholar、Crossref 三个综合源(其它源不认中文)。
- 模型给的不够、或模型失败时,用规则补:课题整句 + 多词关键短语 + 关键词两两组合 + review / survey 变体。规则生成的会在执行记录里记一条「按主题与关键词规则生成检索式」的调整。
- 你在确认页改过的检索式优先,改过就不重新生成。
检索式条数有最低要求:专业档至少 6 条。免费档目前也按专业档的检索深度跑(检索式数、源数、滚雪球轮数、精读量都一样),你可以在确认页把目标篇数调低,但最低动作量不会跟着降。
9 个源并行,公共知识库先查
检索源共 9 个:OpenAlex、Semantic Scholar、arXiv、PubMed、Europe PMC、Crossref、OpenAIRE、DOAJ、CORE。每条检索式 × 每个源是一次调用,线程池并行发出,每个源有自己的限速令牌桶,整个并行检索有 90 秒总预算,到点没回来的组合记 timeout,用已回来的结果继续。
顺序不是固定的:课题里含「医学 / 临床 / 药 / 基因 / 蛋白 / cancer / neuro」这类词时,PubMed 和 Europe PMC 排最前;其它课题按后台配置的优先级。每个源、每条检索式最多取「目标篇数 × 2」条,夹在 15–50 之间。
站内的公共知识库(之前所有研究晋升进来的条目)对每条检索式都先查一遍,不占外部配额。公共库命中且相关度 ≥ 0.6 的条目在筛入时先占最多 30% 名额,因为它们已经有全文、实体和引用链,写作时引用成本最低。
同一检索式、同一源的结果缓存 7 天。你在执行记录里看到「缓存命中」就是这个。
阈值:至少 5 个源应答、且至少 2 个源真有命中,否则文献阶段失败,不会「差不多」继续。某个源超时或出错会先记一条调整(「文献库 xxx 暂时不可用,已跳过」),最低源数随之下调,但底线是 2 个。你在确认页只勾了很少的源也一样:会先提示「可用的文献库较少」,再按现有源跑。
去重
先按强标识合并:DOI → arXiv id → PMID,任一相同即同一篇。没有强标识的再按标题模糊匹配:标题归一后 Jaro-Winkler 相似度 ≥ 0.93 且年份差 ≤ 1 年才合并;两边都有强标识但不同的,标题再像也不合并。
合并时保留元数据最全的一条为底,来源列表取并集,被引数取最大;任一源说撤稿就按撤稿处理。合并掉的条数就是文献页「去重」那个数字。
初筛:撤稿、年份、类型
精筛之前先按元数据剔除:撤稿的(PubMed 出版类型、Crossref 的 Retraction Watch 数据)、年份超出窗口两端各 1 年的、勘误 / 撤稿声明 / 社论 / 快讯 / 读者来信类型的。
剩下的按一个软分数排序:0.5 × 源相关分 + 0.3 × log(被引 + 1) + 0.2 × 新近度(近 10 年线性),三项都在本批内归一。只有排在前面的进精筛:精筛池 = 目标篇数 × 4,且不少于 150 篇(轻量模式 30 篇)。目标 50 篇时,进精筛的是前 200 篇;剩下的不打分、不入库,在检索统计里算作「未进入精筛」。
精筛怎么判
精筛按 12 篇一批交给抽取模型,每篇给标题、年份和摘要前 700 字,输出三样:相关度 0–1、一句入选 / 淘汰理由(必须提到与研究问题的关系)、一句核心发现。摘要是外部文本,会被标为不可信输入再喂给模型。
某一批模型失败,这一批退回规则打分:0.5 × 初筛软分数 + 0.5 × 关键词覆盖率(命中标题或摘要计 1,命中标题再加 0.5)。规则打分的理由末尾带「(自动生成)」,文献页「怎么选的」能看出来,检索统计里也分开计数(模型判定 / 规则判定)。
最后按相关度、再按被引数取前「目标篇数」篇筛入,L 编号按相关度排:L1 最相关。淘汰的也入库,文献页「候选(未筛入)」能展开看每篇的淘汰理由。
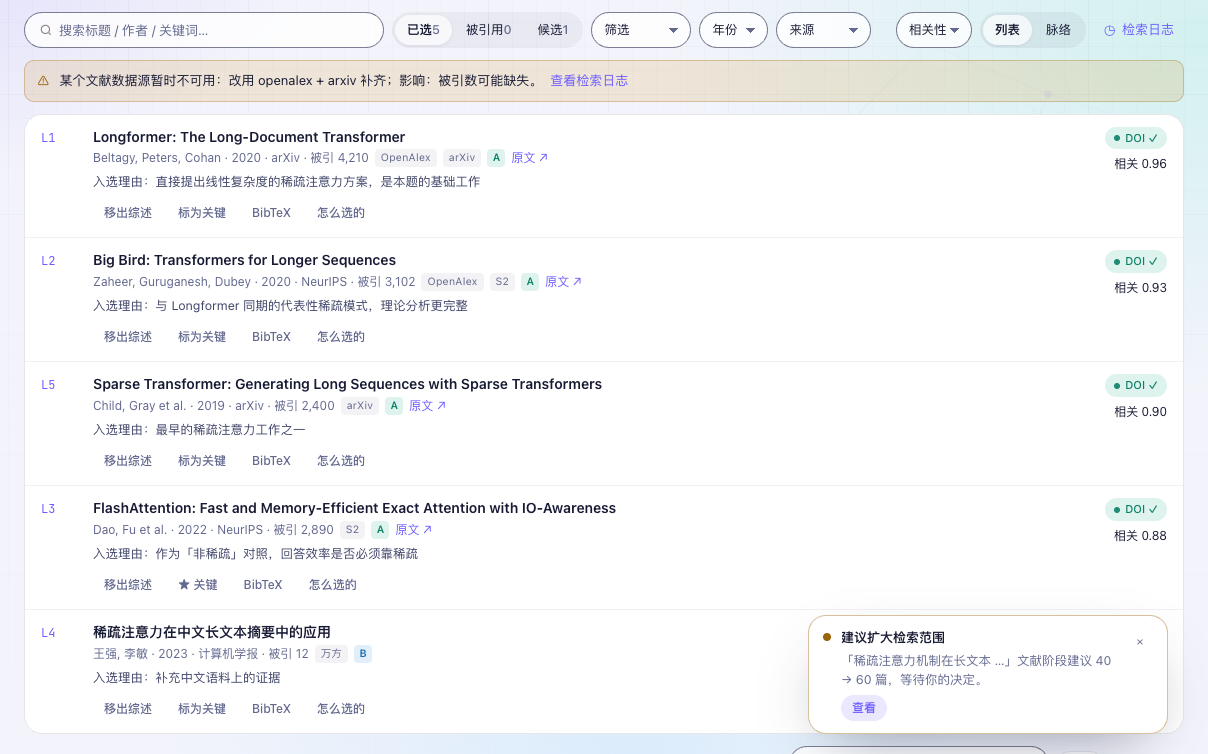
每条文献都带一行入选理由和相关度分数,右侧 DOI 打勾表示已核验;「仅摘要」标签说明没取到全文。底部能展开未筛入的候选,也能贴 DOI 或上传 PDF 手动加。
滚雪球
筛入结果出来后,取前 10 篇做引文扩展:每篇向后(它引用的)和向前(引用它的)各取最多 30 条,源按 OpenAlex → Semantic Scholar → Crossref 依次试,第一个返回非空就停(Crossref 只有参考文献,不做向前)。另外把这 10 篇送给 Semantic Scholar 推荐接口再拿 30 条。
新候选并进池子后重新去重、初筛、精筛。专业档滚 2 轮;某一轮没带来新候选就提前停;全部轮次共用 90 秒预算,到点记一条「引文扩展提前结束」的调整。执行记录里 sb1:backward、sb2:rec 这样的标记就是滚雪球来源。
反证检索
主检索的检索式是从研究问题正向生成的,精筛又按「相关」打分,整条链天然偏向支持主流结论的文献。所以文献阶段最后单独跑一轮反证检索:取前 2 个英文关键词,套 6 个固定模板(limitations / "negative results" / failure / "no improvement" / contradictory / replication),不经模型生成检索式。
召回的候选最多评估 40 篇,模型只判立场:contradicts(结果相反)/ limits(报告了失效条件或代价)/ supports / unrelated,并要求给出摘要里的逐字片段作依据。片段在摘要里核不到就不算反证。最多纳入 6 篇,和普通文献一样有 L 编号,文献页标「反证 · 相反结果」或「反证 · 限定条件」。这一段任何失败都只进日志,不影响阶段。
A / B / C 等级
等级只看被引数,且是本次候选池内的相对分位:
- A:被引在池内前 10%,且不是预印本
- B:被引在中位数以上
- C:其余,以及所有预印本(另标「未同行评审」)
样本少于 10 篇时前 10% 没有统计意义,只有被引最高的那一篇能进 A;被引为 0 的一律 C。这不是期刊分区,同一篇文献在不同课题的池子里可能拿到不同等级。
目标篇数与实际筛入
默认目标 50 篇(企业版 100),确认页可以在 1 到档位上限之间调。实际筛入比目标少的原因基本就这几种:候选池去重、初筛后不够;某些源不可用;筛入后你手动移出了。实际比目标多的情况:反证检索纳入的几篇、你手动添加的。
数据分析任务选了论文体裁时,会附加一段轻量文献阶段:目标 20 篇、不滚雪球、只读 30 篇摘要,只为引言和相关工作供引用。
阈值不达标就是阶段失败,通知会说「本次未扣次数」,从文献阶段重试即可;重试时同一检索计划的结果有断点(并行检索 / 精筛 / 每轮滚雪球都存了 checkpoint),不会重新检索。
全文:全部索引,只有一部分能站内看
筛入的每篇都尝试取全文,顺序固定:Unpaywall(按 DOI 查合法开放获取链接)→ arXiv PDF → 候选自带的开放获取链接。只认文件头是 %PDF 的响应(拦截页也是 200),首页标题与文献标题相似度 ≥ 0.85 才算取到;超过 50 MB 不存;401 / 403 视为付费墙,不模拟登录,不接任何非法渠道。
预算三层:单个链接 45 秒、单篇 90 秒、整个阶段 600 秒。阶段预算用完,剩下的标 pending,先按摘要成文,后台补齐作业每 10 分钟一轮继续取(每日最多 300 次尝试),取到后自动进资料库。
取到的全文全部入索引,可被检索和 AI 分析,但只有许可证允许再分发的能在站内阅读:CC0、CC-BY、CC-BY-SA、CC-BY-ND、公有领域,以及你自己上传的 PDF(只有你能看)。CC-BY-NC 家族和出版社限制的全文只索引不展示,文献页给原文链接。ND 类不做改写式摘录。
检索统计怎么进论文
文献阶段结束时,检索统计会写成一个伪作业「检索统计」的指标,每项有 D 编号:检索式条数、检索命中、去重后、筛入、源数、滚雪球轮数,加上精筛 / 淘汰 / 模型判定与规则判定 / 未进入精筛 / A、B、C 篇数 / 预印本 / 有全文 / 用户添加 / 反证检索各项。综述的「范围与方法」、论文的 Methods 只能通过占位符引用这些数,代码展开成数值加 [D n] 记号;模型自己写的裸数字过不了数字门禁。报告里的检索流程表按漏斗顺序列:检索命中 → 去重移除 → 未进入精筛 → 精筛 → 淘汰 → 筛入(A / B / C)→ 滚雪球 / 公共库 / 反证 / 用户加入。
你能改什么
- 文献页可手动添加:贴 DOI / arXiv id,或上传 PDF(≤ 60 MB),30 秒内校验并回填元数据。手动加的文献重跑文献阶段时不会被清掉。
- 筛入 / 移出:移出一篇后,报告里引用它的论断会被标为待核实,可重新生成相关小节。
- 标为关键:只是标记,不改变排序和引用。
- 方法学信息(设计 / 样本 / 数据 / 对照 / 结局 / 局限)在成文开始时逐字从摘要或全文抽取,原文没写的记「未提及」,不做推断。