
主题
确认页:四张卡各管什么、改了会发生什么
解析完成后进入确认页。这一页的所有设置在点「开始研究」的那一刻冻结成研究协议,之后改不了——所以值得花一两分钟。页面顶部是系统改写的研究问题,中间是四张卡,下面是材料、数据源和细节调整。
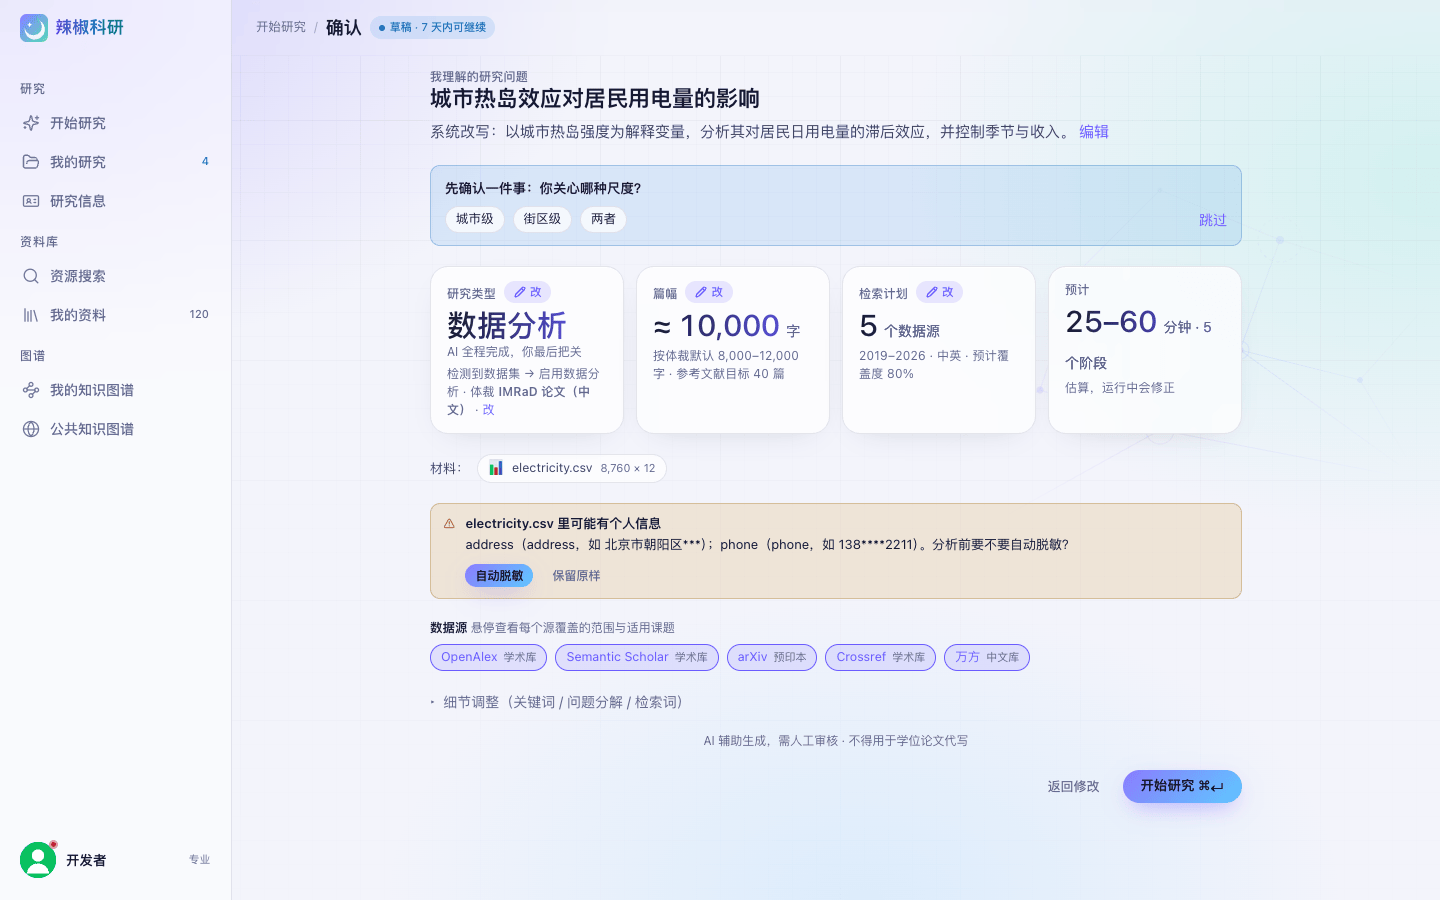
从上往下扫一遍:研究问题 → 澄清问题(有时才出现)→ 四张卡 → 材料与脱敏 → 数据源,最后才是「开始研究」。
先看研究问题
「我理解的研究问题」是系统改写后的一句话。理解偏了点「编辑」直接改(至少 5 个字),保存后只重跑检索计划子步,不重新解析整个课题。改写的问题同样要过内容安全检查。
澄清问题
只在系统把握不足(置信度低于 0.7)时出现,最多 2 题、每题最多 4 个选项,都是选择题。回答后置信度抬到 0.7,检索计划按回答重排。「跳过」只是在页面上把题标成已跳过,系统按原理解继续。设置里开了「无疑问自动开始」的话,没有澄清题时会自动点开始。
卡 1:研究类型 · 体裁
显示当前类型、要跑的阶段序列(如「主题解析 → 文献调研 → 论文撰写 → 导出」)和写作体裁。
- 改类型:点「改」选五种之一,服务端重新展开阶段、重算耗时。系统建议了别的类型时这里会写「系统建议 X · 采用」。
- 体裁:由研究类型和任务语言决定——文献综述 → 综述体裁(review),数据分析 / 论文初稿 / 综合研究 → IMRaD 研究论文,实验设计 → 报告。改类型会连带重算体裁。悬停体裁名能看到它是「本次指定 / 你的偏好 / 按规则」哪一种来的。
- 有数据集且类型不是文献综述时,这里会提示「检测到数据集 → 启用数据分析」。
五种类型各跑哪些阶段见 研究类型;体裁的章节结构见 体裁与篇幅。
卡 2:篇幅 · 参考文献
目标字数:没设时显示体裁默认区间的中点,附「按体裁默认 lo–hi」。各体裁默认区间:
| 体裁 | 默认区间 | 显示的中点 |
|---|---|---|
| 研究论文(IMRaD,英文) | 5,000–8,000 词 | ≈ 6,500 |
| 研究论文(IMRaD,中文) | 8,000–12,000 字 | ≈ 10,000 |
| 文献综述(英文) | 6,000–10,000 词 | ≈ 8,000 |
| 文献综述(中文) | 8,000–12,000 字 | ≈ 10,000 |
| 中文研究报告(快速) | 1,500–2,500 字 | ≈ 2,000 |
点「改」可以选按体裁默认 / 5,000 / 8,000 / 12,000 / 20,000 / 30,000;接口允许 3,000–30,000。中文按字、英文按词计。篇幅按比例分到各章节,选 30,000 不会让系统多找文献——长篇要扎实,参考文献目标也要跟着调。
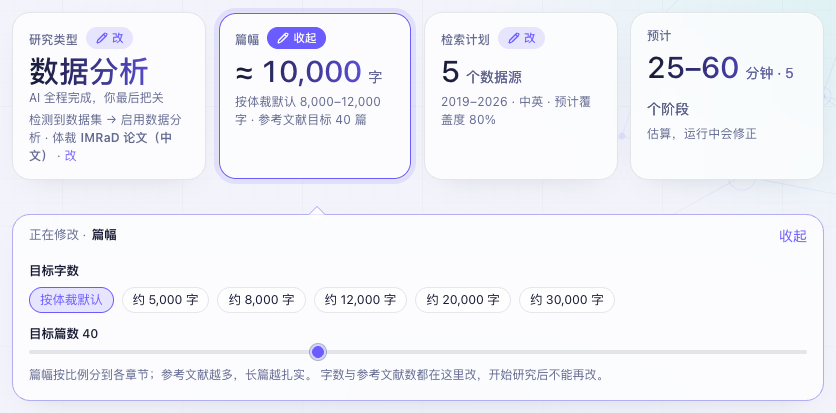
目标字数和参考文献篇数在同一个面板里改;被点开的那张卡高亮、按钮变成「收起」。
参考文献目标:默认 50 篇,可调 1–50。它是文献阶段的筛入目标,不是保证数;实际筛入多少取决于检索结果,见 文献检索与筛选。
卡 3:检索计划
显示数据源个数、年份范围、检索语言,有历史样本时还有「预计覆盖度」。点「改」展开:
- 年份:起止年,默认往前 10 年。页面接受 1990 到今年。
- 语言:中文 / 英文两个 chip,至少留一个。这是检索文献的语言,不是论文语言。
- 数据源:见下一节。
卡 4:预计耗时
按近 14 天同类研究(同阶段、同档位、同规模)的实测用时给出区间;没有足够样本时显示「估算,运行中会修正」。改类型、改篇数、改源都会重算。参考量级:纯综述约 30 分钟,带数据 40–60 分钟。
数据源一排
确认页下方一排 chip,悬停看每个源覆盖什么、适合什么课题(说明按界面语言显示)。点选即时保存,至少保留一个,点掉最后一个会被提示。灰色的是当前档位不可用或后台未启用的源。公共知识库不在这排里——它总是先查。
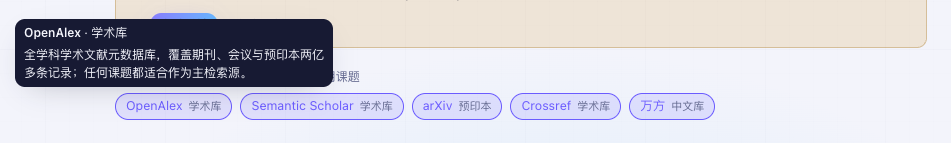
悬停任一源就能看到它管什么、适合什么课题;示例只显示了部分源,线上共 9 个学术源。
各源覆盖范围、生物医学 / 计算机 / 人文社科各勾哪几个,见 数据源怎么选。
已经在库里找到的文献
公共知识库里已有相关文献时会列出几篇,标注「公共知识库里已有 N 篇与这个课题相关」。这几篇是现成的,开始后先用它们打底,外部源检索照跑。
材料与脱敏
每个上传文件一行:PDF 显示解析页数和抽出的种子引用数,数据集显示行 × 列。
数据集里被扫出个人信息列(姓名、手机、邮箱、身份证、银行卡、诊断等)时,会出现一张提示卡列出列名和打码样例,问「分析前要不要自动脱敏?」:
- 自动脱敏:分析读取数据时把这些列换成盐化哈希(同一值同一哈希,分组统计不受影响)。原文件不改。
- 保留原样:会记一条「用户选择保留个人信息列」的决策事件。
这个选择只能在确认前做。没做选择就开始,默认按脱敏处理。
细节调整
折叠在最下面:关键词(最多 20 个、单个 ≤ 80 字)、问题分解、检索词。改关键词会重排检索计划。一般不用动。
点「开始研究」之后
- 次数在这一刻计:本月免费 3 次没用完就走免费,用完扣已购次数,都没有会在这里被拦下。规则见 次数与购买。
- 研究问题、子问题、纳入排除标准(年份 / 语言 / 目标篇数 / 源)被冻结为研究协议,写进论文的「范围与方法」或 Methods。这是为了保证计划在结果之前,不是看了结果再补的说辞。
- 之后再改范围会得到「只能在确认前修改范围」(409)。能做的:暂停 / 继续 / 取消、从某个阶段重试、在报告页删论断和图、按评审意见修订。
- 材料的脱敏选择也随之冻结。
坑
- 草稿 7 天有效,过期后确认会报「草稿已过期」;同时最多 10 个未确认草稿。
- 「解析中」时四张卡还没出来,页面每 2 秒刷新;解析失败草稿仍可确认,系统会用规则方法兜底。
- 参考文献目标上限 50,填更大的数会报错而不是静默截断。
- 数据源的说明是给人看的,检索时系统仍按课题的领域把生物医学源排前。